Disponibilité
Engagé sur une mission longue durée à temps complet depuis août 2025.
Des interventions très courtes et ponctuelles restent possibles — formations, ateliers, conseil ponctuel. Contactez-moi pour valider mes disponibilités.
Les entreprises disposent souvent déjà de toutes les connaissances dont elles ont besoin.
Le problème n’est pas l’absence d’information — c’est la difficulté à l’exploiter au bon moment.
Procédures internes, documentation technique, contrats, guides utilisateurs, référentiels qualité, FAQ, bases documentaires, données métier — la plupart des organisations disposent déjà d’un patrimoine informationnel important.
Pourtant, retrouver rapidement la bonne information reste difficile. Les collaborateurs perdent du temps à chercher des documents, sollicitent les mêmes experts ou naviguent entre plusieurs outils sans trouver immédiatement ce qu’ils cherchent. Les nouveaux arrivants mettent des semaines à devenir autonomes. Les équipes support répondent en boucle aux mêmes demandes.
Un assistant IA documentaire permet d’interroger vos propres contenus en langage naturel et d’obtenir des réponses précises, sourcées et directement basées sur vos documents — pas sur les connaissances générales d’un modèle IA généraliste.
L’objectif n’est pas de remplacer votre documentation. C’est de la rendre beaucoup plus accessible, exploitable et utile au quotidien.
Ce que vous obtenez concrètement#
Accès immédiat
Moins de sollicitations
Connaissances valorisées
Montée en compétence
Meilleure continuité
Réponses traçables
Votre organisation est concernée si…#
Vos collaborateurs passent du temps à chercher des documents
Les mêmes questions reviennent régulièrement
Vos connaissances sont dispersées entre plusieurs outils
Certaines expertises reposent sur quelques personnes clés
Les nouveaux arrivants mettent trop de temps à être opérationnels
Une approche centrée sur les usages, pas sur la technologie#
La réussite d’un assistant documentaire dépend beaucoup moins du choix du modèle d’IA que de la qualité des données, de l’organisation des contenus et des usages réellement attendus par les utilisateurs.
Mon approche consiste à partir des besoins métier, des processus existants et des sources d’information disponibles — avant de choisir une architecture technique. Un assistant que personne n’utilise parce qu’il répond à côté ou qu’il est difficile d’accès ne crée aucune valeur, quelle que soit la sophistication de l’infrastructure.
Cette approche est cohérente avec mon parcours en veille stratégique, gestion des connaissances et systèmes d’information : la valeur ne vient pas de la technologie, elle vient de la pertinence de l’information au bon moment pour la bonne personne.
À qui s’adresse cette offre ?#
- PME industrielles et bureaux d’études — documentation technique, normes, procédures qualité, dossiers projets
- Cabinets de conseil et entreprises B2B — offres, études de cas, références, données CRM, documentation client
- Organismes de formation — ressources pédagogiques, référentiels, contenus de formation, aide aux formateurs
- Services support et relation client — FAQ, documentation produit, procédures de traitement des demandes
- Directions et management — procédures internes, référentiels RH, documentation stratégique
Cas d’usage par domaine#
Support interne et connaissances
Support client et assistance
Documentation technique et conformité
Formation et onboarding
Recherche multi-documents
Portail de connaissances
Exploitation de fichiers serveurs
Comment fonctionne la solution ?#
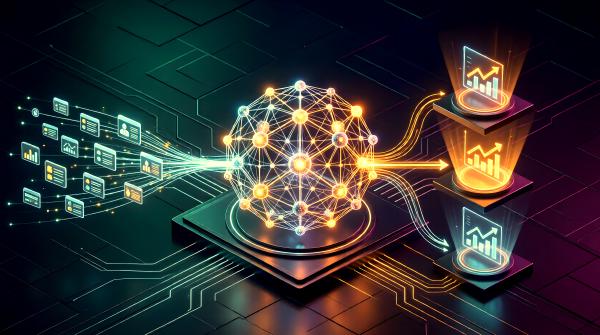
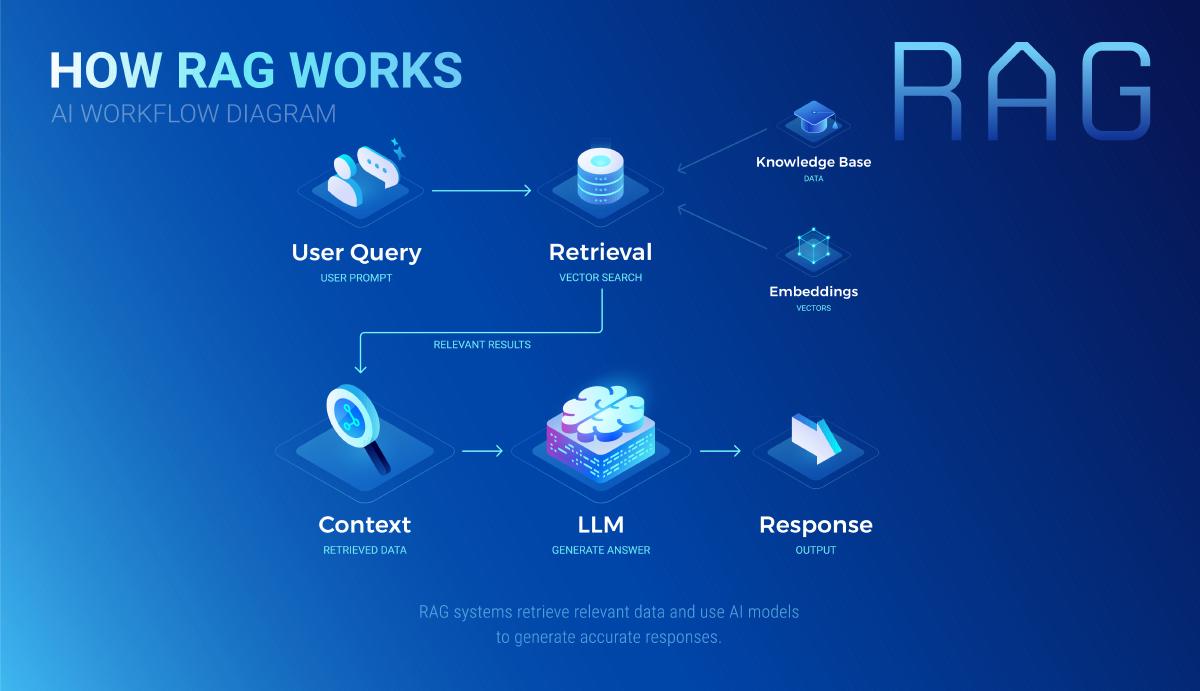
L’assistant ne répond pas uniquement à partir de ses connaissances générales. Avant de générer une réponse, il recherche d’abord l’information dans vos propres documents — c’est le principe du RAG (Retrieval-Augmented Generation).
Concrètement : vos documents sont collectés, structurés et indexés de manière à permettre une recherche sémantique rapide. Lorsqu’un utilisateur pose une question, l’assistant identifie les passages les plus pertinents dans votre base documentaire, puis génère une réponse contextualisée en s’appuyant sur ces extraits — qu’il cite en référence.
Cette approche améliore considérablement la pertinence des réponses et limite les erreurs fréquemment observées avec les assistants IA généralistes qui inventent des informations qu’ils ne connaissent pas.
Déroulement de la prestation#
- 1
Mise en place (forfait)
Audit et cadrage — identification des usages, des utilisateurs, des données disponibles et des contraintes de sécurité. Cette étape détermine les sources à connecter, les cas d’usage prioritaires, les niveaux d’accès et les indicateurs de succès.
Collecte et préparation des données — les contenus sont collectés, nettoyés, enrichis et structurés. La qualité de cette étape est déterminante pour les performances de l’assistant. Des pipelines d’alimentation automatisés peuvent être mis en place pour maintenir la base à jour.
Construction de la base de connaissances — les données sont transformées et indexées dans une architecture adaptée au projet (voir ci-dessous).
Déploiement de l’assistant — mise à disposition d’une interface conversationnelle selon vos besoins : portail web interne, assistant embarqué dans un extranet ou portail client, interface proche de ChatGPT ou Claude.
Sécurité et gouvernance — droits d’accès, confidentialité, cloisonnement des données, traçabilité des requêtes, guardrails pour encadrer les réponses.
Délais indicatifs :
- 3 à 5 semaines pour un assistant documentaire sur un corpus bien défini
- 5 à 8 semaines pour un projet multi-sources avec intégrations et gouvernance avancée
- 2
Exploitation continue (abonnement)
Ajout de nouvelles sources, mise à jour automatique des contenus, amélioration de la qualité des réponses, supervision, optimisation et formation des utilisateurs — sous forme d’abonnement mensuel résiliable avec un préavis d’un mois.
Architectures techniques#
Le choix de l’architecture dépend du volume documentaire, des contraintes budgétaires, des exigences de sécurité et du niveau de souveraineté souhaité.
Architecture AWS Bedrock — Amazon S3, Amazon Bedrock Knowledge Bases, Titan Embeddings ou Cohere Multilingual, modèles Claude, Mistral ou Amazon Nova. Idéale pour les organisations déjà sur AWS ou cherchant un service managé robuste.
Architecture ouverte et portable — PostgreSQL + pgvector, Pinecone, embeddings OpenAI ou Mistral, modèles OpenAI, Anthropic ou Mistral via OpenRouter. Adaptée quand la portabilité ou l’indépendance vis-à-vis d’un fournisseur cloud est prioritaire.
Technologies fréquemment utilisées : Amazon Bedrock, Amazon S3, PostgreSQL + pgvector, Pinecone, Anthropic Claude, OpenAI, Mistral AI, Firecrawl, Python
Sources de données pouvant être intégrées#
PDF, fichiers Office, bases de données, sites web, FAQ, SharePoint, espaces collaboratifs, systèmes documentaires, outils métiers, contenus techniques ou réglementaires. Des outils comme Firecrawl permettent de collecter et structurer automatiquement les contenus de sites web ou centres d’aide pour les intégrer dans la chaîne RAG.
Vos fichiers sur vos serveurs sont exploitables. Si votre entreprise dispose de milliers de fichiers répartis sur des serveurs de fichiers, NAS, drives partagés ou espaces cloud — l’assistant IA peut les indexer et les rendre accessibles à toute l’équipe en quelques secondes via une simple question. Plus besoin de savoir dans quel dossier chercher — l’IA retrouve l’information pertinente pour vous.
Bénéfices observés#
Moins de temps de recherche
Moins de sollicitations répétitives
Patrimoine informationnel valorisé
Montée en compétence accélérée
Continuité de l’information
Meilleure expérience utilisateur
Services complémentaires#
Selon votre contexte, ces services peuvent compléter ou prolonger une solution RAG :
- Veille stratégique et intelligence économique — pour alimenter votre base de connaissances avec des informations de veille collectées automatiquement.
- Centralisation des données métier — pour consolider et structurer les données qui alimenteront votre assistant.
- Transformation opérationnelle par l’IA — pour identifier d’autres opportunités d’automatisation IA dans votre organisation.
- Portails clients et espaces collaboratifs — pour intégrer l’assistant dans un espace sécurisé accessible à vos clients ou partenaires.